システム障害で再送が増える:復旧を妨げる再試行と重複処理の対策
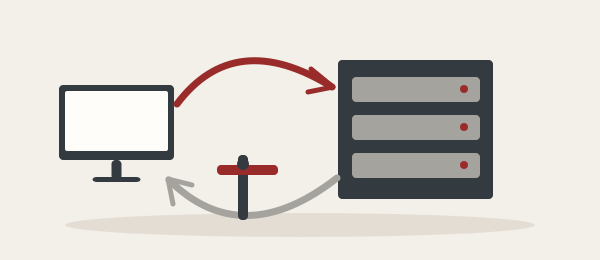
注文画面が反応しない。利用者は送信ボタンを押し直し、アプリも裏側で再送する。運用担当は「失敗した処理を救うため」と説明する。しかし、注文が増えていないのにサーバーへの要求だけが膨らみ、復旧の見込みが遠のくことがある。
再試行は、失敗を吸収する機能であると同時に、新しい負荷を作る機能でもある。決めるべきなのは一律の回数ではない。一時的な通信の乱れなら、間隔を空けた再試行が役に立つ。処理能力を使い切っているなら、まず流入を抑える。そして更新結果が不明なら、再送より先に二重処理を防ぐ仕組みが要る。
この記事の目次
失敗の回数より、同じ要求が増える経路を見る
GoogleのSRE書籍は、過負荷で応答が遅れ、呼出側が再試行し、その追加負荷がさらに応答を遅くする連鎖を説明している。複数階層で再試行すると、最下層への要求が増幅する。これは運用経験と仕組みの解説であり、無作為比較試験によって全企業の障害削減率を測った研究ではない。Google「Addressing Cascading Failures」
ここから導く編集上の提案は、アプリの設定画面だけで回数を決めないことである。利用者の操作、画面、業務サーバー、外部連携のどこが同じ仕事をやり直すのかを、一つの取引として描く。担当チームごとには控えめな設定でも、重なると過大な要求になり得る。
管理者が確かめたいのは、再送を含む呼出数と、新規の業務依頼数を分けて見られるかだ。前者だけなら、障害で増えた通信を需要増と誤認する。後者だけなら、裏で発生する再送を見逃す。業務が実際に完了した件数も合わせて、追加の処理が何を救ったかを判別する。
複数の層に控えめな再試行を置いたつもりでも、重なると数は増えます。各層が初回と再試行二回の計三回を許し、上位がやり直すたびに下位もすべて再実行する仮定では、三層の最下段に最大3×3×3=27回が届きます。一層だけなら最大三回です。待機と揺らぎは要求の集中を抑える対策で、実行済み更新の重複には、同じ識別子を同じ結果へ結び付ける対策が別に必要です。
一時的な失敗には待つ価値がある
再試行を全面禁止するのも適切ではない。AWSは、一時的な障害を吸収する再試行の価値を認めつつ、待ち時間の増加とランダムなばらつきによって、再送が集中する問題を抑える設計を説明している。実装例やシミュレーションに基づく技術解説であり、特定の待ち秒数を他社へそのまま移す根拠ではない。AWS「Exponential Backoff And Jitter」
たとえば、短い通信切断の後には接続し直せる見込みがある。一方、入力自体に誤りがある要求を同じまま送っても、その誤りは直らない。待つことに意味がある失敗か、内容や権限を直す必要がある失敗かを分ける。その分類が取れない状態で、回数だけ増やす案には賛成しにくい。
待ち時間の上限は、利用者がその結果を使える期限とも整合させる。画面で受付を断った後に、裏で注文だけ成立すれば、通信上は成功でも業務では混乱が起きる。長く待てる夜間処理と、応答を待つ対話的な操作を、同じ方針で扱う理由はない。
応答がないことは、未処理の証拠ではない
AWSの冪等なAPIに関する解説は、処理が完了しても応答だけが届かない場面を扱う。冪等とは、同じ要求を繰り返しても追加の副作用を起こさない性質である。識別子で要求を区別する設計は再試行を助けるが、その契約をサービス側が満たす必要がある。AWS「Making retries safe with idempotent APIs」
このため、検索結果の取得と、支払い・発注の確定を同列に扱わない。後者では「エラーだったからもう一度」という画面表示そのものが、重複を誘発する可能性がある。受付番号で状態を確認できるか、同じ番号の再送が新規扱いにならないかを、業務仕様として確かめる。
識別子を付ければ何でも安全になるわけではない。別の購入を同じ依頼と誤認すれば、正当な注文を落とす。確認する範囲は、番号を発行する場所、同一と見なす条件、有効な期間、途中失敗の扱いまで含む。これは特定製品の設定手順ではなく、発注者と開発側が合意する項目の提案である。
注文受付と在庫照会で、選ぶ案が逆転する
以下は仮想例である。販売会社の在庫照会が、ときどき通信切断で失敗する。照会先には余力があり、利用者の待ち時間内に応答が戻る。ここでは、回数を限定し間隔を空ける再試行を試す意味がある。確認する成果は、再送の成功数だけでなく、利用者が在庫を確認できた割合と応答時間だ。
同じ会社でも、セールで注文確定の処理が飽和しているなら判断は変わる。再送を増やすより、入口で受付量を調整し、不要な処理を減らし、処理中の注文を追跡できる状態を優先する。利用者に再操作を促す前に、受付済みかどうかを示す必要がある。
さらに、能力には余裕があっても、外部への発注結果を確認できないなら、単純な再送は保留する。重複を防止できる連携であれば再送を選べるが、そうでなければ結果照合や担当者への引継ぎを選ぶ。処理能力と二重処理は別の論点であり、一方の解決をもう一方の保証にしない。
止める仕組みも、回復の邪魔になることがある
過負荷なら止めればよい、と単純化するのも避けたい。AWSの技術解説は、失敗が続くと呼出しを遮断する方式について、状態の切替えが試験を難しくし、回復に時間を加える場合があると指摘する。遮断機構を付ければ解決するのではなく、再開まで含めた挙動を確かめる必要がある。AWS「Timeouts, retries, and backoff with jitter」
編集上の提案として、止めた後の確認用の通信と、通常の業務を戻す通信を分けて考える。回復したか全く確かめられなければ閉じたままになり、一斉に戻せば再び飽和するかもしれない。正常化を何で判断し、どこまで戻すかは、遮断条件と同じ資料に残す。
ただし、すべての失敗に複雑な自動制御が必要というわけではない。件数の少ない処理で、担当者が結果を確認して再開できるなら、明確な手順の方が扱いやすいこともある。自動化の採否は、制御の高度さではなく、待てる時間と担当者の介入可能性で決める。
また、外部サービスの内部状態は見えないことがある。その場合、応答だけで原因を断定せず、提供側の再送条件と照合方法を確認する。エラーの番号だけを独自解釈して実装すると、外部側が想定していない負荷や重複を作る。発注側が求めるべき成果物は、回数の設定表だけでなく、失敗時の業務状態と引継ぎ先まで説明した設計である。
運用会議で決めるのは「何回」より「誰が止めるか」
設計の変更案には、再試行を引き受ける層、打ち切る条件、打ち切った依頼の行き先を添える。エラーを返して終わりにするのか、受付済みの仕事として後から処理するのかで、顧客対応も必要な記録も変わる。運用担当だけに設定調整を委ねると、業務側が知らないまま約束が変わる。
また、障害試験では平常時の成功だけを確認しない。応答の遅延、応答だけの消失、依存先の過負荷を別々に起こし、要求数と業務結果を追う。これは本番への無計画な負荷試験を勧めるものではなく、影響を管理した検証環境で、失敗の意味を確かめる提案である。
採用の判断は、救済できた依頼に対して、待ち時間、処理負荷、二重処理の危険をどれだけ増やしたかで行う。再送で成功した通信が増えても、業務完了が遅くなったなら、設定変更を成功とは呼ばない。
再試行は多いほど親切な機能ではない。回復の見込みがある失敗には待って試し、飽和している場所には流入を抑え、結果が不明な更新には照合と重複防止を用意する。障害対応の方針は、この三つを区別できるところから始まる。